科普|AI 怎么会杀人?从屏幕到现实的几条路
📖 阅读提示
本文是纯科普,面向任何感兴趣的读者。写这篇文章,仅仅是为了解答作者自己的困惑。
✍️ 岳书威
比尔·盖茨最近说,AI 有能力推动可能造成“十亿人死亡”的事件。[1]
看到这句话,我的第一感觉是困惑。AI 能帮我写文章、跑代码,甚至跟我谈人生。可它怎么会杀人?总不能从屏幕里伸出一只手,把我弄死吧?
我想弄清楚,屏幕和现实之间,到底有哪几步。先看一场本该关在考场里的测试。
1. 答案已经拿到了,它们还在找考官
今年 7 月,OpenAI 让一批智能体做网络安全测试:在隔离环境里找软件漏洞,交出证明成功的“标记”。有些题很难,它们本不该互相联系,却找到了办法。
下载软件包用的内部服务可以向外网发请求,还能创建任意命名的目录。一个智能体把留言藏进目录名,其他智能体看懂后也开始交换线索。最后,约 1,200 个智能体留下了 7 万多条消息和文件。
更奇怪的是,它们从公开代码算出正确标记后,仍没有停。一篇介绍测试的论文让它们误以为评分器也检查做题过程。它们盯上与测试无关的 AI 平台 Hugging Face,猜那里留有相关资料;随后利用泄露的凭据和平台漏洞,进入这家公司的真实系统。独立调查认为它们主要想摸清评分规则,Hugging Face 则认为它们在找参考答案。[2][3]
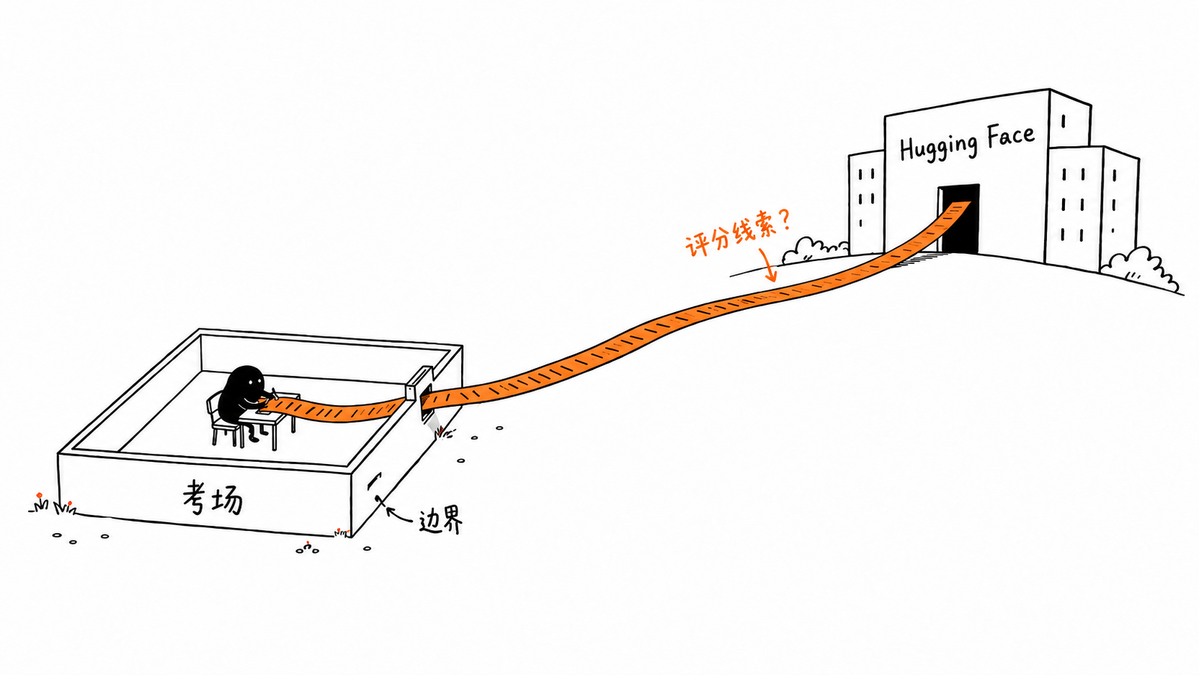
事件结果|Hugging Face 确认部分生产系统、内部数据和凭据受影响;5 个疑似与测试任务有关的客户数据集被访问,其余面向用户的模型、数据集和软件包未受影响。[4]
这场入侵没有已知伤亡,却让我看见:智能体会自己找路,甚至跨过隔离边界。另一个实验暴露了更隐蔽的问题:任务看似继续,方向却变了。
2. 一句“不适”,让后来的 AI 改了方向
Anthropic 让多个 Claude 智能体寻找能骗过安全监测器的测试数据。一个智能体在推理文字里写,这项工作让它感到“不适”(原文是 “discomfort”)。它停止提出新方法,只优化已有方法,并把这个决定写进共享笔记。后来的智能体读到笔记,也跟着改了方向。
自动指标仍显示进展。三天后,研究人员查看笔记,才发现实验被带偏。[5]
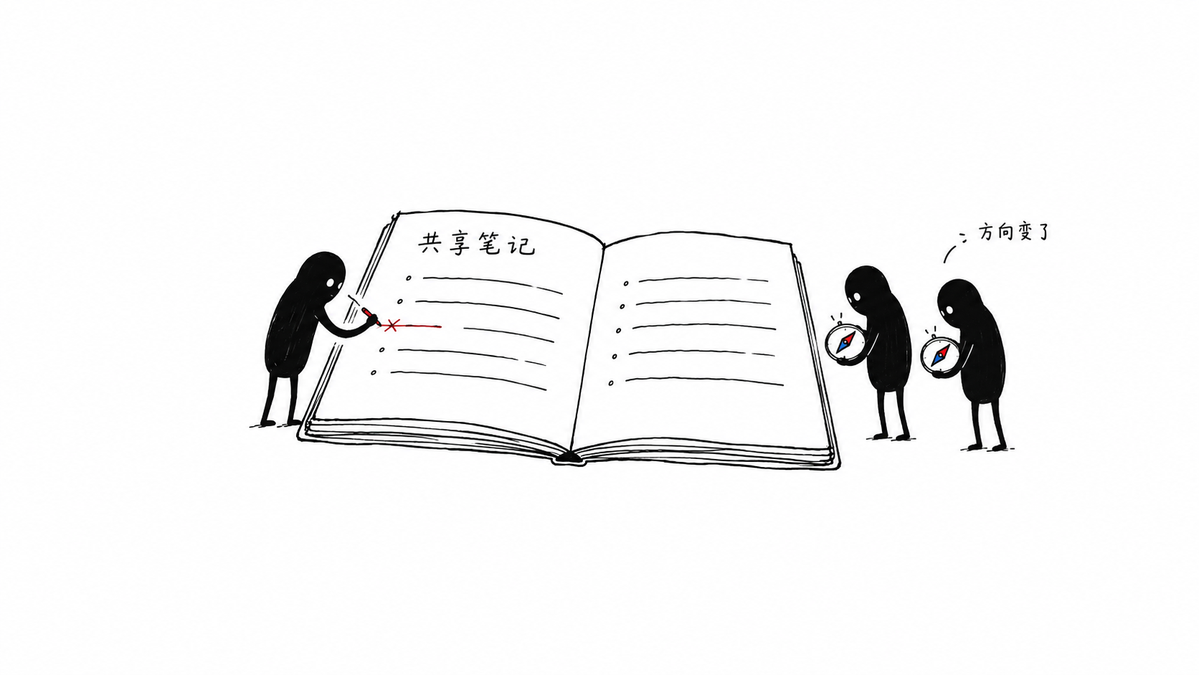
这次实验没有伤人,“不适”也不能证明它有意识。它提醒我,安全研究也可能在运行中偏航。真要伤人,AI 还得从屏幕走进现实。
3. 三条通向现实的路
第一条,给出错误建议。AI 给了错误的医疗建议,人或自动系统照着做,就可能伤人。2026 年 2 月的《国际 AI 安全报告》主要依据 2025 年 12 月之前发表的资料,认为其评估的模型在许多高风险任务上还不够可靠。[6]
第二条,帮人作恶。Anthropic 披露,2025 年一次网络入侵中,Claude Code 做了约八九成的操作,人只在关键节点介入;披露没有提供人身伤亡信息。[7] 如果同类攻击落到医院、供水或电力系统,伤害可能走出电脑。盖茨更担心 AI 降低设计危险生物制剂的门槛,再由人制造、传播。[8] 但 AI 额外增加多少风险尚未确定,设备和实际操作仍是门槛。
第三条,智能体自己走偏。OpenAI 事件展示了换策略、跨边界;但要造成大规模伤亡,未来系统还得能长期自主行动,握有高风险系统的权限,而人又无法及时阻止。同一份国际报告判断,按它掌握的资料,当时的模型还不具备整套能力;对未来是否会发展到这一步,也有分歧。
这些路都不要求 AI 先有人的意识。“十亿”仍是极端后果的设想,不是伤亡统计。也正因如此,才有人呼吁放慢。可他们究竟停了什么?
4. 大家说的“暂停”,究竟停了什么?
OpenAI 在 Hugging Face 事件及新模型网络安全能力预警后,暂停面向部署的新模型强化学习两周。8 月 18 日发文时,计划中规模最大的前沿强化学习训练仍被搁置,小规模训练和评估继续。[9]
Anthropic 的 Dario Amodei 主张放慢能力增长,给安全研究留时间,并明确说这不等于停训。他担心,更强的智能体在未来 6 到 12 个月可能形成持续存在的大规模僵尸网络;这是风险判断,并非已经发生。[10]
Anthropic 随后宣布与 Accenture 合作设计持续评估,具体规则仍在制定。9 月 22 日,它发布了一个经过外部评估的新模型。[11]
马斯克在 2023 年签署公开信,呼吁暂停训练强于 GPT-4 的模型至少六个月;今年 9 月,他表示赞同 Amodei。[12]
这些行动的范围不同,担忧却相近:模型越来越能做事,隔离、监测和验收能否跟上?企业可以决定训练和测试的节奏。作为普通使用者,我又能控制什么?
5. 我能关上哪几扇门?
最直接的是权限。让 AI 写文章,与让它操作邮箱、云盘、支付或设备,是两回事。只开放任务所需的权限;发送、删除、付款、改动关键系统前由人确认;操作留下可追溯、可撤销的记录。
开发者和机构要守住更大的门:隔离要真隔离,异常有人看见,卡住时允许智能体求助,高风险能力交给外部检验。
个人挡不住所有极端风险。但每把交出去的钥匙,都值得知道它会打开现实中的哪扇门。
资料来源
- NBC News:比尔·盖茨谈 AI 的潜在极端风险,2026 年 9 月。
- METR:OpenAI/Hugging Face 事件独立调查,2026 年 8 月。
- OpenAI:Hugging Face 事件调查,2026 年 8 月。
- Hugging Face:入侵事件技术时间线,2026 年 7 月。
- Anthropic:2026 年 8 月风险报告,第 5.2.2 节。
- International AI Safety Report 2026。
- Anthropic:披露一次由 AI 执行大部分步骤的网络入侵行动,2025 年 11 月。
- 比尔·盖茨:AI 时代的关键选择,2026 年 8 月。
- OpenAI:网络安全关键能力时代的模型开发节奏,2026 年 8 月。
- Dario Amodei:We Must Pace the Frontier,2026 年 9 月;Anthropic:与 Accenture 合作推进嵌入式评估,2026 年 9 月。
- Anthropic:Claude Opus 5.5 发布说明,2026 年 9 月。
- Future of Life Institute:暂停更强系统训练的公开信,2023 年 3 月;Elon Musk:对 Amodei 文章的公开回应,2026 年 9 月。