有意思的地方在于:DiT 没有发明一种新的“从噪声画图”步骤,而是把每一步负责清理噪声的主力网络,换成了另一种更容易按规模扩展的结构。
原来的办法卡在哪
扩散模型画图,像从一团雪花屏里反复擦出画面。每擦一次,都要有个网络判断哪些是噪声、画面该往哪里走。过去这份工作通常交给 U-Net:它先把图像逐层缩小,看清整体,再逐层放大,补回细节。这套结构很有效,但也留下一个问题:生成质量依赖的是 U-Net 特有的“缩小再放大”形状,还是去噪任务本身?如果想投入更多计算,网络该怎样长大,也需要系统地测。
作者怎样换掉骨架
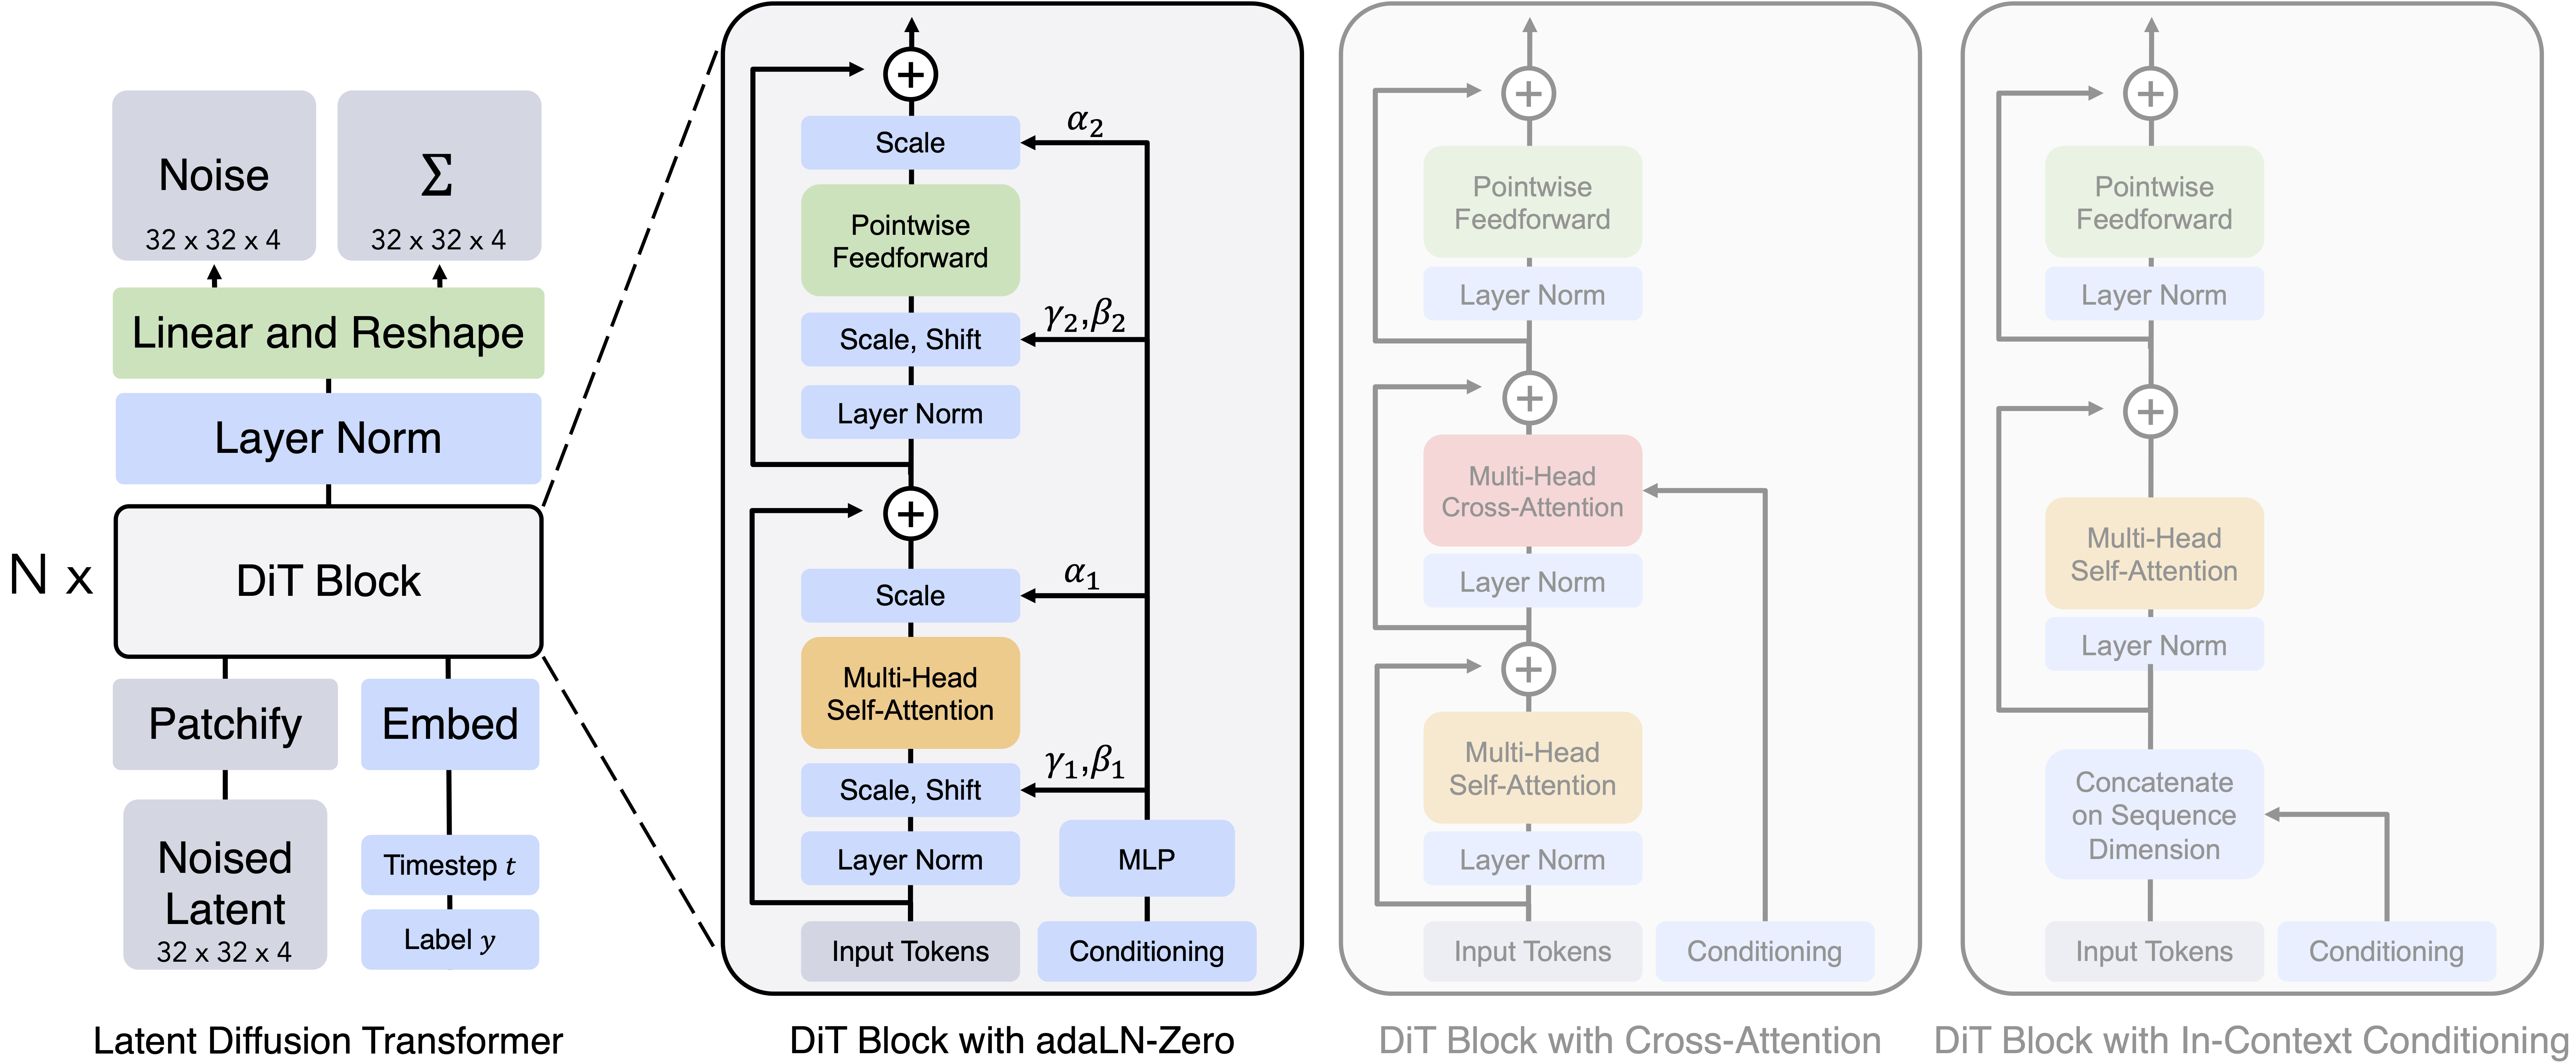
Peebles 和 Xie 的论文先把图片压进一个较小的数字空间,再在那里加噪、去噪;这样不用每一步都处理原图的全部像素。这叫“潜空间扩散”。接着,他们把这份压缩表示切成小块,像把一张地图分成许多格子,交给 Transformer——一种让各格信息相互参考的网络。这个去噪骨架就是 DiT。
关键并非只换名字。模型还得知道当前擦到了哪一步、要画哪一类物体。作者用随条件调整网络内部尺度的方式传入这些信息,并让网络初始时先近似“原样通过”,再逐步学会修改。论文比较了不同大小的模型和图像块:模型变大、块切得更细,通常都让生成结果更接近测试图片的整体分布。作者用 FID 衡量这种接近程度;数值越低越好,但它不能证明单张图的细节真实。
能走向哪里
这项工作给影像生成工作流一个实际选择:底层的“画图发动机”可以采用更通用的 Transformer 骨架,再往上接文字、局部选区或视频帧等控制信息。广告素材生成、相册里的想象式扩图、修图中的内容填补,都可能沿这条路发展。不过这些是后续系统的可能用法,不是这篇论文已经实现的功能。
论文做成的是按物体类别生成静态图片,并在该设定下得到有竞争力的结果;它没有检验文字指令修图、真实照片保真或视频时序一致性。更大的模型和更细的切块也意味着更多计算。因此,DiT 证明了 U-Net 不是去噪的唯一骨架,却没有替真实影像产品回答速度、可控性和真实性的问题。