这篇有意思的地方,不是让大模型再学一个评分器,而是把“预测一个精确分数”改成“先像人一样判断好、较好、一般、较差、差”。
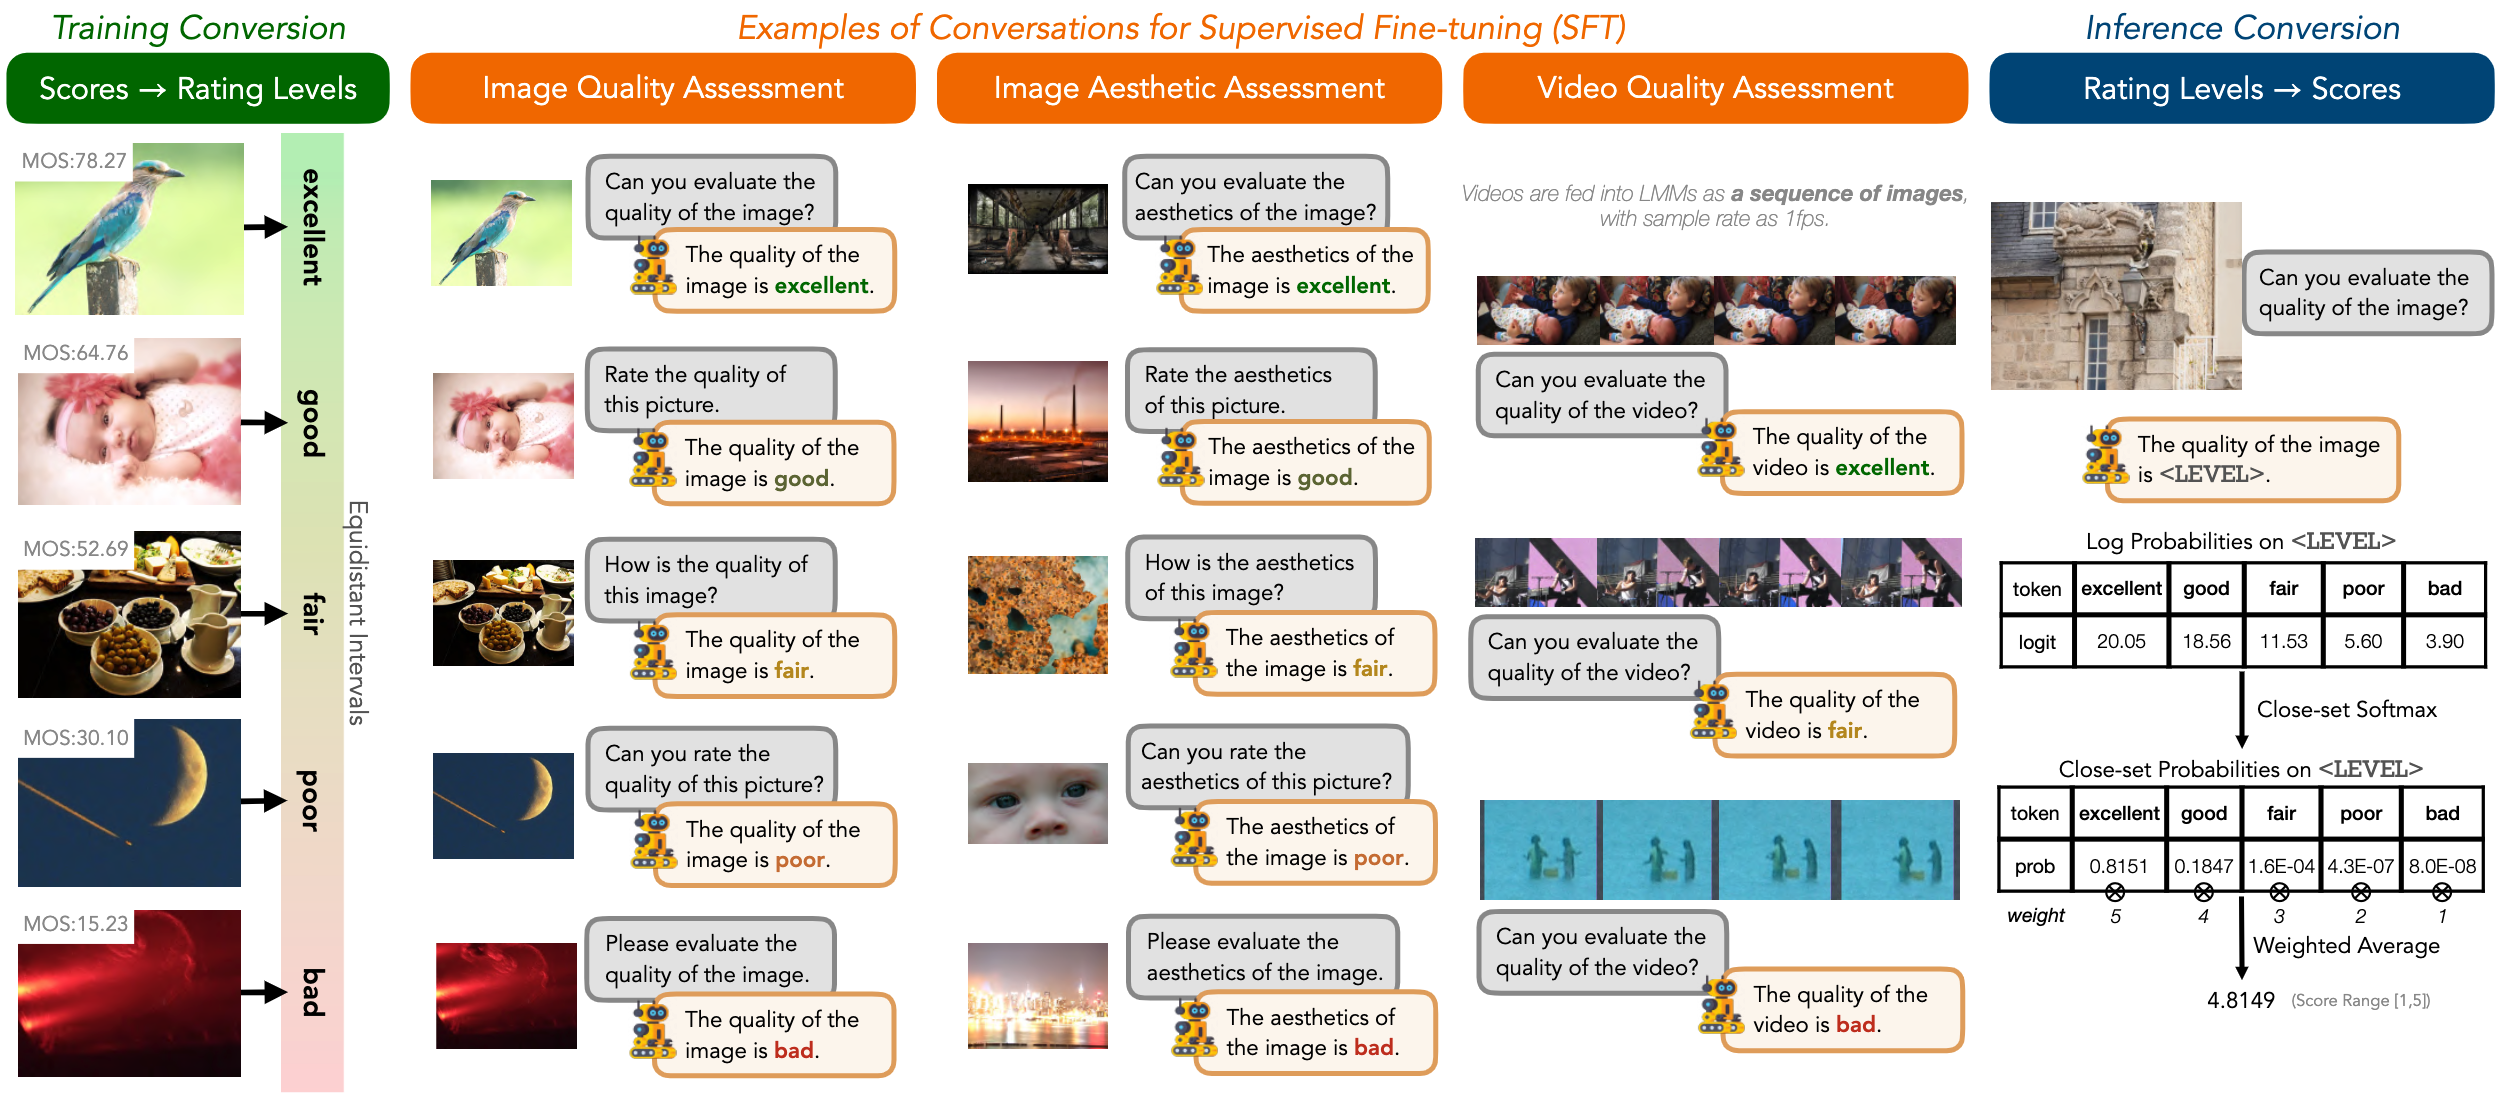
我们平时说一张照片“噪点重”“看着还行”,很少脱口而出“质量是 3.742 分”。但传统画质评价常把许多人的主观意见平均成一个分数,再训练网络直接回归这个数字。问题是,这个平均分只是调查结束后的统计结果,并不是每个评价者真正做出的判断;换一批照片、失真类型或评分尺度,模型很容易把旧数据集的标尺当成画质本身。
Q-Align 的关键转折,就是让大语言模型擅长的“选词”承担评分。这里的大型多模态模型,指既能看图、又能生成文字的模型。训练时,作者把原有分数分到五个文字等级,让模型回答“excellent、good、fair、poor、bad”中的一个。推理时也不只取胜出的词,而是读取五个词各自的概率,再做加权平均,重新得到连续分数。它等于先模拟一组人分别投档,再计算平均意见分;模糊边界因此不会被强行压成一次生硬的数字回归。
论文报告,这套做法覆盖图像质量、图像审美和视频质量三类任务;合并训练得到的 OneAlign 还能用同一模型处理三类评分。在跨数据集测试中,按文字等级训练的版本整体优于直接学习分数的版本。这至少说明,模型已有的视觉与语言知识并非天然不会评画质,关键可能是别用它不擅长的答案形式去教。
如果进入真实工作流,它可以成为相册筛片、短视频上传质检、生成图片排序和修图前后验收的共同“软标尺”:系统不只吐出一个分数,还保留“偏向较好还是一般”的概率,便于设置不同产品阈值。更进一步,拍摄端可以据此决定是否触发连拍融合,编码器也能把更多码率留给模型判断最容易掉档的片段。
局限也很明确。五档标签仍来自原来的平均分切段,无法自动解释到底是噪声、构图还是肤色出了问题;把视频抽成若干帧,也可能漏掉抖动、卡顿等时间问题。论文证明的是评分相关性和跨数据集泛化,不等于它已经理解了每一次主观偏好,更不等于可以不经校准就替代具体产品的人因测试。