InstructPix2Pix 有意思的地方,是把「告诉模型成品长什么样」变成「告诉它这张图要改什么」。
一句话修图,难在没说出口的部分
假设想把照片里的马换成龙。手工修图要选区、换素材、补背景;把整张照片重新交给文生图模型,又可能连人物和构图一起换掉。「换成龙」背后其实还藏着一句:其余地方尽量保留。
这篇由 Tim Brooks、Aleksander Holynski 和 Alexei A. Efros 提出的工作,发表于 arXiv 2022 年。它把原图和修改指令一起交给模型,不要求用户重写完整画面描述,也不必先手动画选区。这种交互至今值得追问:模型究竟学会了修改,还是只是重新画得相似?论文入口
先制作一本「改前—指令—改后」课本
训练卡在数据:网上照片很多,却很少附有修改指令和对应成品。
作者先用少量人工示例微调语言模型,让它从原图描述写出修改指令及新描述;再让文生图模型把两份描述画出来。为避免两次生成各画各的,生成时共享部分文字与画面位置的对应关系,再筛掉变化不合要求的图像对。这样,两个大模型先充当教材作者。作者的数据生成说明
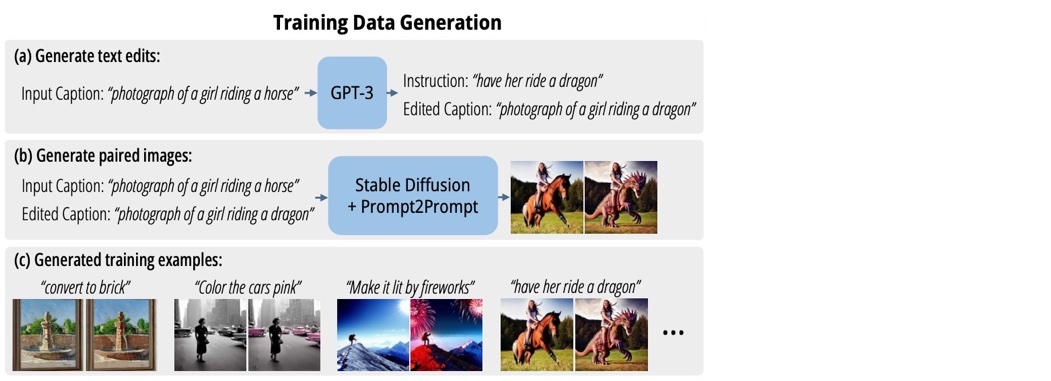
接着,用这本课本训练编辑模型。它采用扩散方法:从噪声逐步生成画面,每一步都参考原图和指令。使用时无需为每张照片单独训练;还可以分别调节「保留原图」与「服从文字」的力度。论文方法
成没成:能改,但不能保证只改那里
论文展示了真实照片上的换背景、改材质等结果。与「给原图加噪再重画」的对照路线相比,作者报告:在自动指标认为编辑完成程度相近时,其结果更接近原图。但这些指标衡量的是模型特征中的相似程度,不等于逐像素保真,也不能代替用户验收。论文实验
产品里,还需要一份「改动清单」
一种可能的用法,是相册先根据一句话生成候选,用户再用前后对照决定是否保留。电商修图也可先试材质与背景,但商品文字、轮廓应另行检查。视频剪辑可以借它探索单帧风格;连续帧是否稳定,需要另外解决。
这些是应用设想。真正有用的后续能力,是标出哪些地方被改动,让用户确认模型有没有越界。
论文已给出失败案例:找错对象、过度修改、不能可靠交换位置。合成教材还会继承出题模型的盲点。因此,这条路线确立了指令修图的可行性,却没有解决「没让改的地方必须不动」这道更严格的题。论文局限