这篇有意思的地方,是把“替某类物体训练一个抠图工具”,变成了“给同一个模型不同提示,就能取得不同选区”。
想只提亮照片里的一件外套,第一步往往最费事:告诉软件哪些像素属于它。手动画边缘很慢;按固定类别识别的工具,又未必认识眼前这件东西。即使点一下就能选,也有歧义:点在袖子上,要的是袖子、外套,还是整个人?
Alexander Kirillov 等人的《Segment Anything》提出视觉基础模型 SAM,也就是在大量图像上训练、可迁移到不同分割任务的通用模型。这里的分割,是生成一张标明“哪些像素被选中”的掩膜。它借用了大模型的提示思路,但提示可以是点击或方框。
关键转折是承认“一次点击可能有几个合理答案”。SAM 可以给出多个候选掩膜,避免把袖子和整个人硬平均成奇怪的轮廓。模型先处理整张图,保存可复用的图像特征;之后用户补点或改框,由较轻的部分更新选区,不必每次重算整图。方法见原文第3节。
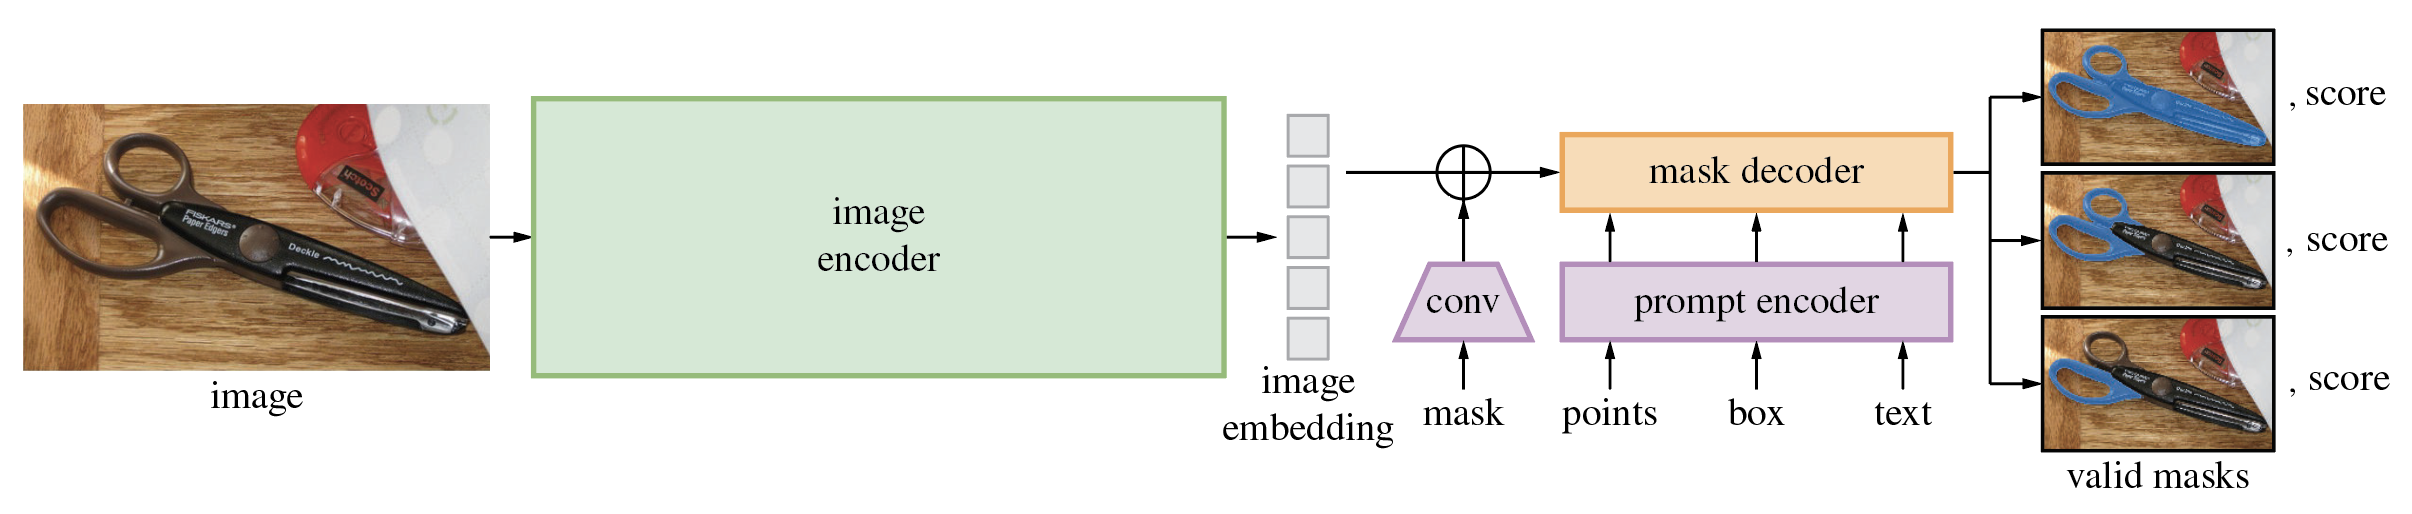
这种通用性也需要数据支撑。作者让模型先辅助人工描选区,再让人补充遗漏物体,最后扩大到自动标注。模型帮助造训练数据,新数据又帮助模型处理更多情况。作者仓库提供了点、框提示与自动生成掩膜的使用入口。
成没成?论文在单点提示测试中,不针对测试集重新训练;在23个数据集中的16个上,SAM 的预测选区与标注选区重合得比交互分割对手 RITM 更好。默认按模型自己的置信度选答案。文中另有看过标准答案再挑候选的结果,那是真实使用时做不到的分析,不能混为产品能力。结果与协议见第7.1节。
它值得继续讨论,是因为“先确定操作范围”贯穿影像工作流。以下是应用推想:相册可让用户点出要处理的物体;修图软件可把选区交给调色或生成式填补工具;拍摄界面可用点击指定局部测光区域。视频里还需要额外解决跨帧跟踪,不能把逐张选得好直接当成整段稳定。
局限恰好也在这里:选出范围,并不等于知道该如何改。作者承认模型会漏细小结构、产生零碎误选;提示响应快,也不代表首次处理整图快。文字提示仍是探索,不能理解为公开模型已经能稳定“听话抠图”。若要精修发丝或处理半透明边缘,还得检验选区是否足够细致。局限见第8节。