TRELLIS 有意思的地方,是把“生成哪种三维文件”变成了“先生成一份共同底稿,再决定怎样使用它”。
给一张椅子的照片,让模型做出能旋转查看的椅子,难点不只是补出背面。三维数据没有照片那样统一的像素格式:三角形网格便于处理表面形状;三维高斯则用许多带颜色、透明度的小椭球组成画面,擅长呈现外观。前者未必留得住丰富纹理,后者又未必能提取干净表面。生成系统一开始选了格式,后续用途便容易受限。论文背景
Jianfeng Xiang 等人的这篇论文,为这种分裂找了一个中间层。他们把空间切成小格子,只保留碰到物体表面的格子,再给每格附上一份记录形状与外观的压缩信息。这就是“结构化潜表示”:可以理解成有地址的局部笔记,空白空间不用逐格记账。
这些笔记怎样学出来?训练时,作者从多个角度渲染已有三维物体,用已经学会提取图像特征的视觉基础模型读图,再把对应信息汇到空间格子里。生成时则分两步:先确定哪些地方有表面,再补上局部细节。最后由不同解码器——把压缩信息还原成可用数据的网络——输出不同格式。同一套空间地址,也让指定区域的增删替换有了着力点。方法说明
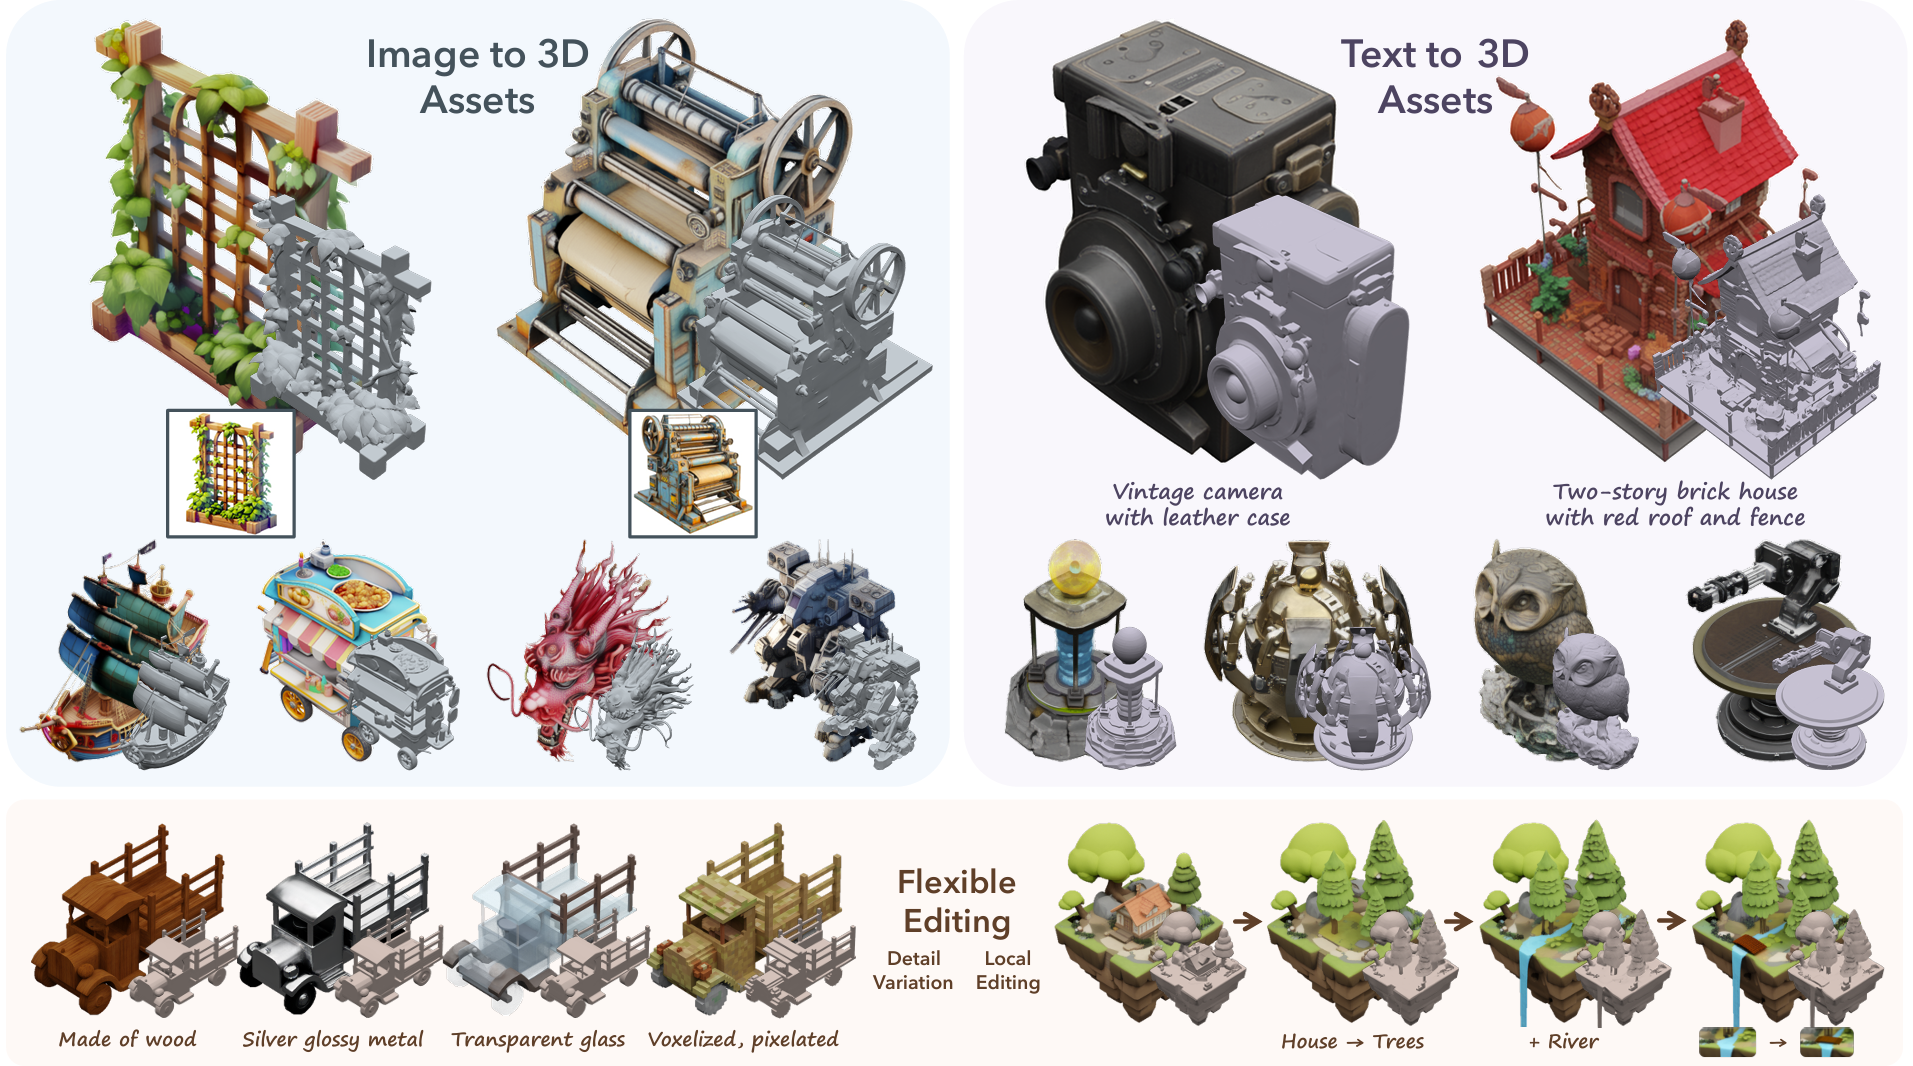
成了吗?作者在未用于训练的 Toys4k 三维物体数据上,报告了相对所比较方法的外观、几何与输入匹配优势;还让参与者看旋转视频,选择更符合输入、整体质量更好的结果,TRELLIS 获得更多偏好。这支持“能生成更有用的资产”,但并不等于从照片恢复了物体的真实尺寸与背面。实验与用户研究
沿这条思路,电商拍摄可以先用商品图生成摆位草模,短视频制作可以先试机位,再决定哪些道具值得精建;相册中的纪念物,也可能变成可旋转观看的内容。这些是可能的工作流延伸,关键在于同一物体能接入不同工具,而不是每换用途就从头生成。商品展示仍须核实不可见面,不能把补出的细节当实物证据。
最扎实的局限来自作者自己:模型没有把照明与物体外观分开,参考照片中的阴影、高光会被“烘”进去。换灯光时,原来的亮斑可能还粘在表面上。因此,能旋转的模型还不等于能重新布光的摄影资产。共同底稿解决了格式之间的衔接,材质与照明的分离仍是下一道关。论文局限